在线客服
扫描二维码
下载博学谷APP
扫描二维码
关注博学谷微信公众号
HDFS有着高容错性特点,且设计用来部署在低廉的硬件上,提供高吞吐量来访问应用程序的数据,适合那些有着超大数据集的应用程序。HDFS放宽了POSIX的要求,可以实现流的形式访问文件系统中的数据。
Hadoop分布式文件系统HDFS是一种被设计成适合运行在通用硬件上的分布式文件系统。HDFS是一个高度容错性的系统,适合部署在廉价的机器上。它能提供高吞吐量的数据访问非常适合大规模数据集上的应用。
HDFS概念
HDFS(Hadoop Distributed File System)是 Apache Hadoop 项目的一个子项目. Hadoop 非常适于存储大型数据 (比如 TB 和 PB), 其就是使用 HDFS 作为存储系统. HDFS 使用多台计算机存储文件, 并且提供统一的访问接口。
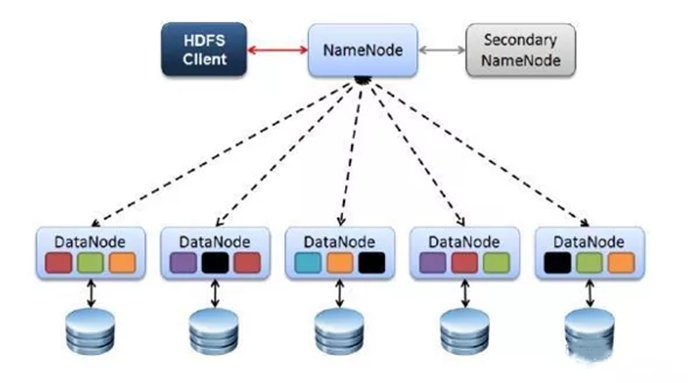
HDFS的四个基本组件:HDFS Client、NameNode、DataNode和Secondary NameNode。
HDFS采用主从结构模型,一个HDFS集群是由一个NameNode和若干个DataNode组成的。其中NameNode作为主服务器,管理文件系统的命名空间和客户端对文件的访问操作;集群中的DataNode管理存储的数据。
Client
Client是客户端。HDFS Client文件切分。文件上传 HDFS 的时候,Client 将文件切分成 一个一个的Block,然后进行存储。Client 提供一些命令来管理 和访问HDFS,比如启动或者关闭HDFS。
NameNode
NameNode就是 master,它是一个主管、管理者。管理 HDFS 元数据(文件路径,文件的大小,文件的名字,文件权限,文件的block切片信息)。
NameNode管理 Block 副本策略:默认 3 个副本,处理客户端读写请求。
DataNode
DataNode就是Slave。NameNode下达命令,DataNode 执行实际的操作。DataNode存储实际的数据块,执行数据块的读/写操作。定时向namenode汇报block信息。
Secondary NameNode
SecondaryNameNode不是NameNode的备份。当NameNode挂掉的时候,它并不能马上替换NameNode并提供服务。
辅助 NameNode,分担其工作量。在紧急情况下,可辅助恢复 NameNode。
副本机制
HDFS被设计成能够在一个大集群中跨机器可靠地存储超大文件。它将每个文件存储成一系列的数据块,这个数据块被称为block,除了最后一个,所有的数据块都是同样大小的。
为了容错,文件的所有block都会有副本。每个文件的数据块大小和副本系数都是可配置的。
在hadoop2 当中, 文件的 block 块大小默认是 「128M」(134217728字节)。

如图所示,一个大小为300M的a.txt上传到HDFS中,需要进行128M的切分,不足128M分为到另一block中。
— 申请免费试学名额 —
在职想转行提升,担心学不会?根据个人情况规划学习路线,闯关式自适应学习模式保证学习效果
讲师一对一辅导,在线答疑解惑,指导就业!
上一篇:
大数据开发培训哪家好?怎么选?
下一篇:
机器学习在线学习网站哪个好?
相关推荐 更多

大数据Hbase面试题汇总
在大数据中,我们总会碰到Hbase数据库。尤其对于即将要面试大数据的小伙伴来说,Hbase数据库更是绕不过去的一个重要考点,因此小编汇总了近些年来比较常见且经典的大数据Hbase面试题,希望可以帮到大家。
10423
2019-08-20 18:49:37
程序员必须掌握的大数据分析核心技术有哪些?
程序员必须掌握的大数据分析核心技术有哪些?大数据分析技术现是一种传统的技术分析模型,主要对数据进行筛选、过滤之后进行分析。随着银行业、保险业,电子商务的不断发展,非结构数据的数量越来越多,增加了大数据分析的难度,对于大数据方面的程序员要求越来越高。
9265
2020-03-05 15:19:17
ZooKeeper数据模型解析
ZooKeeper的数据模型采用树形层次结构,而Znode就是ZooKeeper树中的每个节点。和文件系统的目录树一样,ZooKeeper树中的每个节点可以拥有子节点。但也有不同之处: 比如Znode兼具文件和目录两种特点,而且它还具有原子性操作,存储数据大小也有限制。另外,Znode还是通过路径引用。下面我们来看看数据结构图、节点类型、节点属性以及ZooKeeper Watcher相关内容。
8074
2020-06-15 10:32:03
大数据智能与人工智能的联系和区别
现在进入了互联网时代,提出人工智能概念,人工智能已经在多个领域中实践,比如无人驾驶、图像识别、语音识别等领域。大数据不断采集、沉淀、分类等积累数据,人工智能基于大数据的支持和采集,运用于人工设定的特定性能和运算方式来实现。
8765
2020-07-27 16:48:30
Spark SQL 结构化数据处理流程及原理是什么?
Spark SQL 可以使用现有的 Hive 元存储、SerDes 和 UDF。它可以使用 JDBC/ODBC 连接到现有的 BI 工具。有了 Spark SQL,用户可以编写 SQL 风格的查询。
5732
2022-05-25 11:35:20