在线客服
扫描二维码
下载博学谷APP
扫描二维码
关注博学谷微信公众号
Spark作为一种分布式的计算框架,类似于大数据开发中Hadoop生态圈的MapReduce,计算思想和MR非常相似,两者都是分而治之的思想,但使用率要比MR高很多。本文整理了关于Spark运行架构的大数据面试题,内容包括Spark运行的基本流程、架构特点、优势。
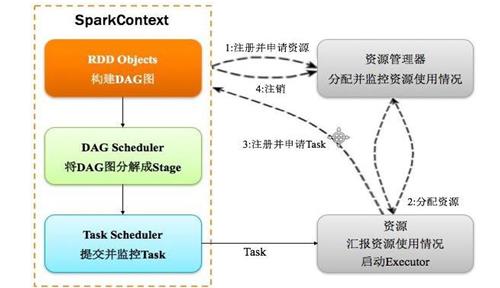
1、Spark 运行基本流程:
(1)构建 Spark Application 的运行环境(启动 SparkContext),SparkContext 向资源管理器(可以是 Standalone、Mesos 或 YARN)注册并申请运行 Executor 资源;
(2)资源管理器分配 Executor 资源并启动 Executor,Executor 运行情况将随着心跳发送到资源管理器上;
(3)SparkContext 构建成 DAG 图,将 DAG 图分解成 Stage,并把 Taskset发送给 Task Scheduler。Executor 向 SparkContext 申请 Task,Task Scheduler 将Task 发放给 Executor 运行同时 SparkContext 将应用程序代码发放给 Executor。
(4)Task 在 Executor 上运行,运行完毕释放所有资源。
2、Spark 运行架构特点:
(1)每个 Application 获取专属的 executor 进程,该进程在 Application 期间一直驻留,并以多线程方式运行 tasks。
(2)Spark 任务与资源管理器无关,只要能够获取 executor 进程,并能保持相互通信就可以了。
(3)提交 SparkContext 的 Client 应该靠近 Worker 节点(运行 Executor 的节点),最好是在同一个 Rack 里,因为 Spark 程序运行过程中 SparkContext 和Executor 之间有大量的信息交换;如果想在远程集群中运行,最好使用 RPC 将SparkContext 提交给集群,不要远离 Worker 运行 SparkContext。
(4)Task 采用了数据本地性和推测执行的优化机制。
3、Spark的优势:
(1)计算效率高
资源复用;粗粒度的资源调度。
(2)使用方便
支持使用多门语言来编写;提供了超过80多种方法来供我们使用。
(3)通用性强
Spark生态圈中的组件都是基于SparkCore封装起来的。
(4)适应性强
可以接受上百种数据源;可以运行在各种各样的资源调度框架上。
以上就是大数据面试题,所有关于Spark运行架构的内容,不知道对大家梳理Spark运行架构的知识点,有没有帮助?
— 申请免费试学名额 —
在职想转行提升,担心学不会?根据个人情况规划学习路线,闯关式自适应学习模式保证学习效果
讲师一对一辅导,在线答疑解惑,指导就业!
上一篇:
云计算大数据培训哪家好?课程都学什么?
下一篇:
博学谷云计算大数据培训班课程怎么样?
相关推荐 更多
大数据面试:数据仓库工具hive面试题集锦
进入DATE时代,大数据技术成为互联网发展的核心要素之一。与此同时大数据开发工程师的薪资也成为行业内高薪的代表。想从事大数据开发需要掌握多种核心技术:Hadoop、Hive、Storm、Spark、Scala等等。而且这些技术知识点已经成为大数据工程师进入职场时面试中必备的考点。这里主要和大家分享一下数据仓库工具hive相关的面试题!
22024
2019-07-05 17:30:53
大数据面试题之分布式资源调度框架Yarn
Yarn作为一个资源管理、任务调度的框架,其重要性不言而喻。尤其是在近些年的大数据面试中,更是面试题的重点知识之一。为了大家在面试的时候,能够准备的更加充分,小编整理了一份有关分布式资源调度框架Yarn的大数据面试题,内容包括Yarn的架构、工作流程、调度器Scheduler。
10669
2019-09-12 11:00:53

云计算是什么?云计算的通俗解释
云计算是什么?云计算是一种用户可以随意从可配置计算资源共享空间中获取所需资源的模型,这些资源一般是网络、服务器、存储、应用及服务。这样的解释可能对大众来说,依旧不太好理解。下面小编就用最通俗的解释,全面为大家科普云计算的概念。
11051
2019-10-12 10:57:02
Redis是什么?Redis有哪些数据类型?
Redis是什么?Redis是一个高性能且免费的key-value数据库,它可以解决高并发、高扩展和大数据存储等等问题,因此Redis对大数据的作用至关重要。那么Redis有哪些数据类型呢?简单来说有string、hash、list、set、zset五种,下面小编将来详细分析一下这五种数据类型。
9625
2019-11-11 17:51:24
大数据程序员的工作职责是什么?
大数据开发要负责公司大数据平台产品的技术工作,如需求分析、架构设计、研发、以及性能分析工作;提升Hadoop集群的高可用性、高性能、高扩展特性;海量数据的导入优化工作;理和完善各类文档等工作。
7169
2022-06-16 11:05:45