在线客服
扫描二维码
下载博学谷APP
扫描二维码
关注博学谷微信公众号
累加器和广播变量分别在什么场景使用?累加器分布式共享只写变量,如果在转换算子中调用累加器后续没有行动算子,累加器不会执行。后续如果调用了两次行动算子,会执行两次累加器出现多加的情况。
1、广播变量的使用方法介绍
解决的场景:
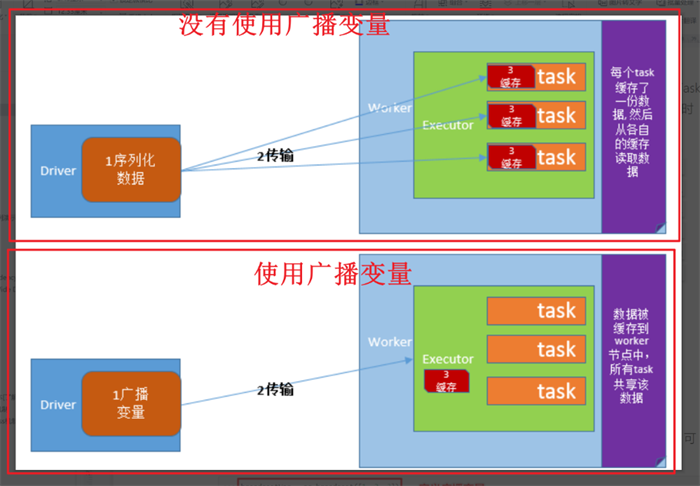
将Driver进程的共享数据发送给所有子节点Executor进程的每个任务中。如果不用广播变量技术,那么Driver端默认会将共享数据分发到每个【Task】中,造成网络分发压力大。
如果使用了广播变量技术,则Driver端将共享数据只会发送到每【Executor】一份。Executor中的所有【Task】都复用这个对象。要保证该共享对象是可【序列化】的。因为跨节点传输的数据都要是可序列化的。
在Driver端将共享对象广播到每个Executor:
val bc = sc.broadcast( 共享对象 )
在Executor中获取:
bc.value
2、累加器的使用方法介绍
集群中所有Executor对同一个变量进行累计操作。Spark目前只支持累【加】操作。有3种内置的累加器:【LongAccumulator】、【DoubleAccumulator】、【CollectionAccumulator】。
整数累加器使用方法
在Driver端定义整数累加器,赋初始值。
acc=sc.accumulator(0)
在Executor端每次累加1
acc+=1
或者acc.add(1)
3、综合案例
# -*- coding:utf-8 -*-
# Desc:This is Code Desc
from pyspark import SparkConf, SparkContext
import os
os.environ['SPARK_HOME'] = '/export/server/spark'
PYSPARK_PYTHON = "/root/anaconda3/bin/python3.8"
# 当存在多个版本时,不指定很可能会导致出错
os.environ["PYSPARK_PYTHON"] = PYSPARK_PYTHON
os.environ["PYSPARK_DRIVER_PYTHON"] = PYSPARK_PYTHON
if __name__ == '__main__':
#需求1:从大量用户中,剔除掉黑名单用户
conf=SparkConf().setAppName('sharevalue_review')\
.setMaster('local[*]')
sc=SparkContext(conf=conf)
sc.setLogLevel('WARN')
#创建大量用户
rdd_all=sc.parallelize(['zs','ls','ww','zl'])
#创建黑名单用户
black_list=['zs','ls']
#定义广播变量
bc=sc.broadcast(black_list)
#从大量用户中剔除掉黑名单用户
def filter_black(str):
#获取广播变量
black_list2=bc.value
if str in black_list2:
return False
else:
return True
filterd_rdd=rdd_all.filter(filter_black)
print('过滤后:')
print(filterd_rdd.collect())
#需求2:从大量数字中,挑选出带有7的数字,并计算他们的平均值。
#定义大量数字
rdd_all2=sc.parallelize(range(1,1001))
#定义累加器
#定义累加器1 ,记录有多少个7
acc = sc.accumulator(0)
#定义累加器2 ,将带有7的数字加起来
acc2=sc.accumulator(0)
def find7(i):
global acc
global acc2
if '7' in str(i):
acc+=1
acc2+=i
rdd2=rdd_all2.map(find7)
rdd2.count()
num_7=acc.value
sum_7=acc2.value
avg_7=sum_7/num_7
print('带有7数字的个数是',num_7,'他们的平均数是',avg_7)
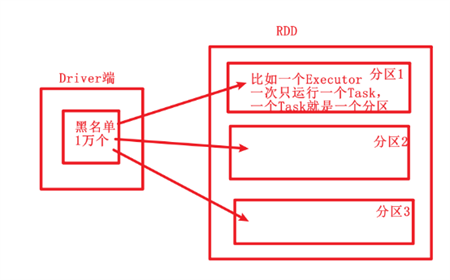
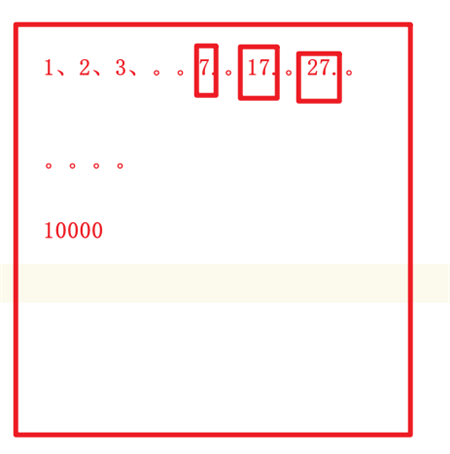
小伙伴们一定要自己亲手敲代码进行练习,以上代码不仅练习了累加器和广播变量如何使用,还涉及了函数式编程(Map、Filter)如何使用,上下文变量如何创建、如何用并行化集合的方式创建RDD等,这些练习比较综合,希望可以帮助大家学到更多的技能。
— 申请免费试学名额 —
在职想转行提升,担心学不会?根据个人情况规划学习路线,闯关式自适应学习模式保证学习效果
讲师一对一辅导,在线答疑解惑,指导就业!
上一篇:
大数据spark框架常用数据类型RDD与DataFrame的区别
下一篇:
大数据的核心价值是什么? 本质是什么?
相关推荐 更多
大数据与人工智能对保险行业的风险控制与挑战
大数据与人工智能对保险行业的风险控制与挑战,万物互联、大数据与人工智能是改变根本的技术革命。它在很大程度上解决了困扰人类几千年的信息不充分、不对称的问题,极大地提高了人类整合资源、协调行动、科学决策的能力,必将引发一场空前的社会大变革。
12228
2019-04-11 14:11:31
Hadoop基础知识快速入门
学习大数据的同学都知道,Hadoop是一个很重要的知识点。本文主要概括了Hadoop的定义、优势和作用,带大家了解Hadoop基础知识能够快速入门。
9662
2019-08-08 20:13:01
零基础学大数据现实吗?需要经历哪些过程?
零基础学大数据现实吗?需要经历哪些过程?首先我们要明白学习任何东西都是从无到有,零基础学习大数据并没有什么劣势,只不过是比有一定编程基础的学习者多付出一些努力,因此不要随意给自己设限,认为零基础这不能学,那不能学。其次零基础学习者要学好大数据无外乎两点,一是清晰的学习内容规划,二是适合自己的学习模式。下面小编就来讲讲零基础如何学习大数据。
9240
2019-10-09 16:02:32
程序员必须掌握的大数据分析核心技术有哪些?
程序员必须掌握的大数据分析核心技术有哪些?大数据分析技术现是一种传统的技术分析模型,主要对数据进行筛选、过滤之后进行分析。随着银行业、保险业,电子商务的不断发展,非结构数据的数量越来越多,增加了大数据分析的难度,对于大数据方面的程序员要求越来越高。
9096
2020-03-05 15:19:17
大数据Hadoop生态体系中常见的子系统有哪些?
Hadoop是一个针对大量数据进行分布式处理的软件框架,是一个开发和运行处理大规模数据的软件平台,是Appach的一个用Java语言实现开源软件框架,实现在大量计算机组成的集群中对海量数据进行分布式计算,具有可靠、高效、可伸缩的特点,很多程序会用到这个框架。
7627
2021-03-17 13:58:05