在线客服
扫描二维码
下载博学谷APP
扫描二维码
关注博学谷微信公众号
Pandas如何分块处理大文件?在处理快手的用户数据时,碰到600M的txt文本,用sublime打开蹦了,用pandas.read_table()去读竟然花了小2分钟,打开有3千万行数据。仅仅是打开,要处理的话不知得多费劲。
解决:读取文件的函数有两个参数:chunksize、iterator。原理分多次不一次性把文件数据读入内存中。
1.指定chunksize分块读取文件
read_csv 和 read_table 有一个 chunksize 参数,用以指定一个块大小(每次读取多少行),返回一个可迭代的 TextFileReader 对象。
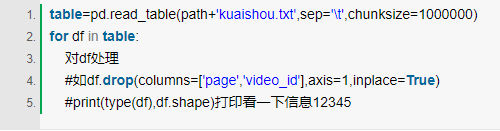
对文件进行了划分,分成若干个子文件分别处理(to_csv也同样有chunksize参数)
2.指定iterator=True
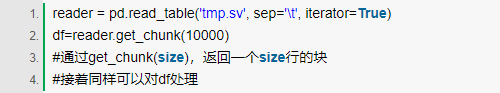
直接看pandas文档相关的内容。
— 申请免费试学名额 —
在职想转行提升,担心学不会?根据个人情况规划学习路线,闯关式自适应学习模式保证学习效果
讲师一对一辅导,在线答疑解惑,指导就业!
上一篇:
数据可视化常用工具推荐
下一篇:
零基础能学大数据技术吗?学完能找到工作吗?
相关推荐 更多
博学谷云计算大数据培训班课程怎么样?
在线学习已经成为现在年轻人最主要的学习途径。博学谷作为国内高端的IT在线教育平台,依托传智播客13年教学经验的沉淀,推出云计算大数据培训课程。每年都有非常多的小伙伴在博学谷平台学习,对于还在观望的同学,博学谷云计算大数据培训班课程怎么样?在博学谷学习有什么优势呢?
9057
2019-09-06 18:22:40
数据仓库和数据挖掘的有什么联系和区别?
数据仓库和数据挖掘的有什么联系和区别?首先我们要清楚数据仓库是一个实现数据存放庞大的地方,而数据挖掘是从海量的数据中提取数据。因此这两者在本质上就存在明显的区别,不过两者既相互区别又相互联系,数据仓库和数据挖掘都可以看做是商业智能工具集合。下面我们来好好认识一下数据仓库和数据挖掘的定义、联系和区别吧!
11627
2020-01-12 17:13:04
分布式系统学习笔记
分布式系统其实就是为了处理更多数据而存在的。对于大数据学习者来讲,分布式系统入门还是很容易的。本文为大家总结整理了一篇关于分布式系统的学习笔记,主要内容有分布式系统的定义、常用分布式方案以及分布式和集群的对比,下面一起来看看吧~
7528
2020-06-09 11:12:49
数据分析师获取数据的方式有哪些?
数据分析师工作的第一步就是获取数据,也就是数据采集。获取数据的方式有很多,本文将着重介绍一下数据分析中的数据来源。一般来讲,数据来源主要分为两大类,企业外部来源和内部来源。其中外部来源包括外部购买、网络爬取、免费开源数据等,内部数据来源包括销售数据、考勤数据、财务数据等。
10607
2020-08-07 18:19:53
大数据spark框架常用数据类型RDD与DataFrame的区别
大数据spark框架常用数据类型RDD与DataFrame的区别,在spark中,RDD、DataFrame是最常用的数据类型,在Apache Spark 里面DF 优于RDD但也包含了RDD的特性,在使用的过程中分别介绍下两者的区别和各自的优势。
6604
2022-04-19 11:12:45